在大数据与人工智能深度融合的当下,企业面临的数据环境日益复杂:数据来源多样、结构异构、质量参差、语义冲突。如何构建高效、可靠、智能的数据处理服务体系,成为数字化转型的核心命题。本文基于多个行业项目的实践验证,提出一种以主数据管理(MDM)为基础、AI算法为驱动力的技术架构,并阐述其在数据处理服务中的关键作用与应用成效。
一、实践背景与挑战
传统数据处理服务通常依赖ETL工具与规则引擎,存在三大痛点:
- 数据孤岛严重:客户、产品、员工等核心实体在不同系统中编码不一、属性冲突。
- 清洗与匹配效率低:基于规则的实体解析面对海量、动态数据时,维护成本高、准确率下降。
- 服务响应被动:数据质量监控与修复滞后,难以支撑实时分析与智能决策。
为解决上述问题,我们在金融、零售、制造等领域的项目中,逐步形成并验证了“MDM+AI”的融合架构。
二、技术架构设计
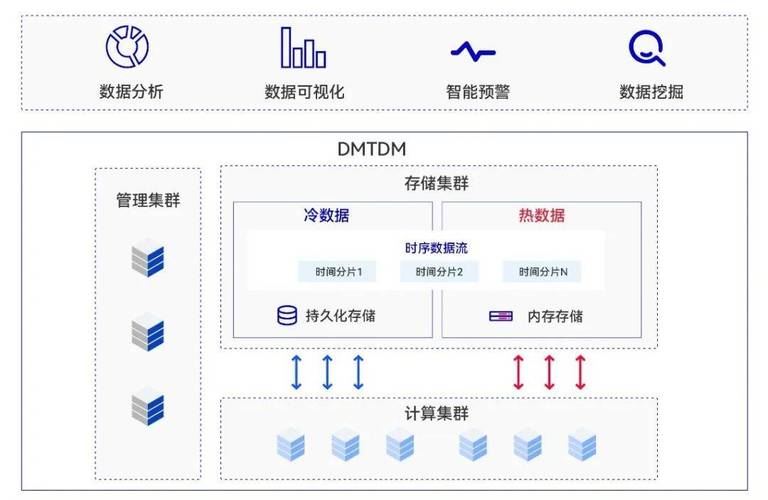
该架构分为三层:主数据管理层、AI算法驱动层、数据处理服务层,并通过统一的数据 Service Bus 和反馈闭环协同工作。
1. 主数据管理层(MDM)作为基础
MDM负责定义核心业务实体(如客户、产品、供应商、组织)的黄金记录,提供唯一可信数据源。具体能力包括:
- 数据建模与层级管理;
- 数据质量规则配置(完整性、唯一性、一致性);
- 数据血缘与变更历史追踪;
- 工作流驱动的审批与分发。
2. AI算法驱动层(AI Engine)作为驱动力
在MDM之上,引入机器学习与深度学习算法,实现从“规则驱动”到“数据驱动”的跃升:
- 实体解析与匹配:采用BERT向量化+相似度学习,自动识别跨系统同一实体,匹配准确率较规则提升25%以上;
- 异常检测:基于孤立森林与自编码器,实时发现主数据异常值;
- 数据补全与标准化:利用机器学习预测缺失属性(如行业分类、地址补全),并自动映射到标准码表;
- 动态权重调整:根据数据源可信度与时效性,AI动态计算融合权重。
3. 数据处理服务层(Data Processing Services)
对外提供可复用的API与微服务:
- 数据接入与清洗服务;
- 实体解析与合并服务;
- 数据质量评分服务;
- 主数据查询与订阅服务;
- 实时数据流处理服务(结合Flink/Kafka)。
三、实践验证案例
案例一:某大型零售集团客户主数据治理
- 背景:CRM、电商、门店POS、客服系统中客户信息冲突严重,营销转化率低。
- 实施:以MDM建立客户黄金记录,AI自动匹配重复客户,补全手机号与地址,实时输出统一客户画像。
- 效果:客户识别准确率从78%提升至96%,营销响应率提升34%,数据清洗人力成本下降60%。
案例二:某制造企业产品主数据协同
- 背景:PLM、ERP、MES中物料编码与属性不一致,导致采购与生产延误。
- 实施:AI驱动的分类与属性映射,结合MDM工作流自动分发标准产品数据。
- 效果:物料查找时间缩短70%,BOM准确率提升至99.2%,库存周转率提高18%。
案例三:某银行实时风控数据处理
- 背景:反欺诈系统需要毫秒级判断客户关联关系。
- 实施:将MDM与图神经网络结合,实时解析客户关联实体,输出风险评分。
- 效果:欺诈识别延迟从秒级降至50ms,误报率降低42%。
四、关键成功因素
- 高层数据战略与组织保障:设立数据治理委员会,明确MDM归属。
- 迭代式AI模型运营:建立标注、训练、评估、部署的MLOps闭环。
- 服务化与API优先:所有数据处理能力以API形式暴露,便于集成。
- 反馈机制:AI处理结果反哺MDM规则库,持续优化。
- 安全与合规:数据脱敏、权限控制、审计日志贯穿全流程。
五、结论与展望
通过多个行业实践验证,以主数据管理为基础、AI算法为驱动力的技术架构,能够显著提升数据处理服务的准确性、效率与智能化水平。MDM提供可信的语义骨架,AI提供动态的、自适应的数据处理能力,二者结合实现了从“被动治理”到“主动服务”的转变。随着大语言模型与知识图谱的融入,该架构将进一步向自动化、可解释、自主演进的数据处理服务生态演进。